2026 年 10 月 22 日,Anthropic 与 Theorem 公布了一项程序验证研究:Claude 为 123 个开源库中的 239 个模糊测试入口完成形式化证明,最终通过检查的 Rocq 代码累计达 1.8 亿行,平均每个测试入口约 75 万行。双方希望通过这一庞大规模的形式化证明,体现其在程序验证上的工程突破。
一、Anthropic 研究成果概览
Anthropic 此次展示的验证对象来自于 Google 的 OSS-Fuzz 项目。在 OSS-Fuzz 项目的设定中,开发者编写模糊测试代码,规定如何调用库函数、检查哪些结果;模糊测试工具则生成输入,反复运行这段代码来寻找错误。此次 Anthropic 与 Theorem 的工作利用模糊测试中的正确性检验代码,以及编译时插桩的安全性检验代码,对其中一批程序开展形式化验证,证明它们满足这些检查所表达的安全性与功能正确性要求。
例如,bzip2 的测试入口先压缩输入,再解压缩,成功后检查还原长度与内容是否和输入相同。图中的两个 assert 就是开发者写下的功能要求,比较失败会中止程序。对这个测试入口的无错误证明,也保证了每次执行到的比较都成立。

图 1:bzip2 的模糊测试入口,经过节选和简化。查看完整源码
在构造证明的过程中,Claude 还会遇到程序确实存在缺陷、验证目标无法成立的情况。实验允许 Claude 修补发现的缺陷,随后针对修改后的程序重新生成验证规格并继续证明;这些补丁同时被记录并接受审计。
据研究报告,这一过程发现了数百个缺陷。其中,一处解压实现的错误由约 20 MB、具有特定数据排列的输入触发:解压过程中计数器发生下溢,随后出现越界写,将数据写到缓冲区边界之外。由于模糊测试通常将输入限制在约 1 MB,因而没能发现该问题;本次证明任务则覆盖小于 64 MiB 的输入空间,使这一约 20 MB 的特殊输入成功纳入检测范围。
报告还点名了证明过程中重新发现的 libexpat 漏洞 CVE-2026-56132。它的上游分析与补丁提供了代码层面的解释:父解析器和子解析器共享数组 scaffIndex,容量信息 m_groupSize 分别保存在各个解析器中。子解析器按自己的较小容量重新分配共享数组,父解析器恢复执行后仍按原容量判断空间充足,随后写入越过了数组的实际边界。
公开仓库收录了其中 25 个库、60 个测试入口的证明。后文以这批代码为依据,沿着验证对象、正确性条件、证明工具和证明构造四个问题展开,再比较具体结论与工程取舍。
这次实验展示了由 AI 构造证明、定理证明器检查结果的工作方式在真实软件上的可行性。验证涉及编译后的指令、指针与内存布局,以及程序依赖的底层运行库。239 个测试入口的成功案例表明,这套流程已经能够用于实际程序中的复杂执行逻辑,具备批量开展程序验证的潜力。
Claude 既构造证明,也编写工具自动生成重复性内容,再交由 Rocq 检查,从而完成大规模的证明任务。Anthropic 的技术附录第 3 至 4 页指出,超过一半的证明材料由 Claude 编写的工具生成,主要包括指令编码和查找表;约四成是定义、模型、引理与证明步骤,其中也有一部分由脚本生成。单份证明的检查需要约半小时至数小时 CPU 时间。
我们统计了公开仓库中 25 个库的材料:按库汇总,证明材料与二进制输入的体积比主要集中在 20~50 倍,少数超过 100 倍。全部 ELF 文件合计约 274 MiB,Rocq 源文件合计约 7.79 GiB,总体积比约为 29 倍。图 2 按各库的比值从大到小排列。

图 2:按库汇总的 Rocq / ELF 体积比。Rocq 统计全部 .v 文件,ELF 累计普通版、ASan、UBSan 和 ASan+UBSan 四种构建。纵轴采用对数坐标,柱内标注两类文件总大小的比值。
在证明两个二进制版本行为一致时,Claude 通常会先写出一份较短的规格,描述程序可能产生的输出,再分别证明两个版本符合这份规格。这意味着 AI 已经能够在具体指令之上提炼行为描述,用它组织后续证明。后文将结合公开代码,展开这些证明的构造方式。
Anthropic 博文提到的其他工作
Anthropic 还比较了不同模型构造证明所需的 token 消耗。在 36 个源自 OSS-Fuzz 的小型验证任务上,Opus 5.5 完成半数任务所需的 token 比 Opus 5 少约 40%。图 3 展示了不同 token 预算下各模型完成任务的比例。
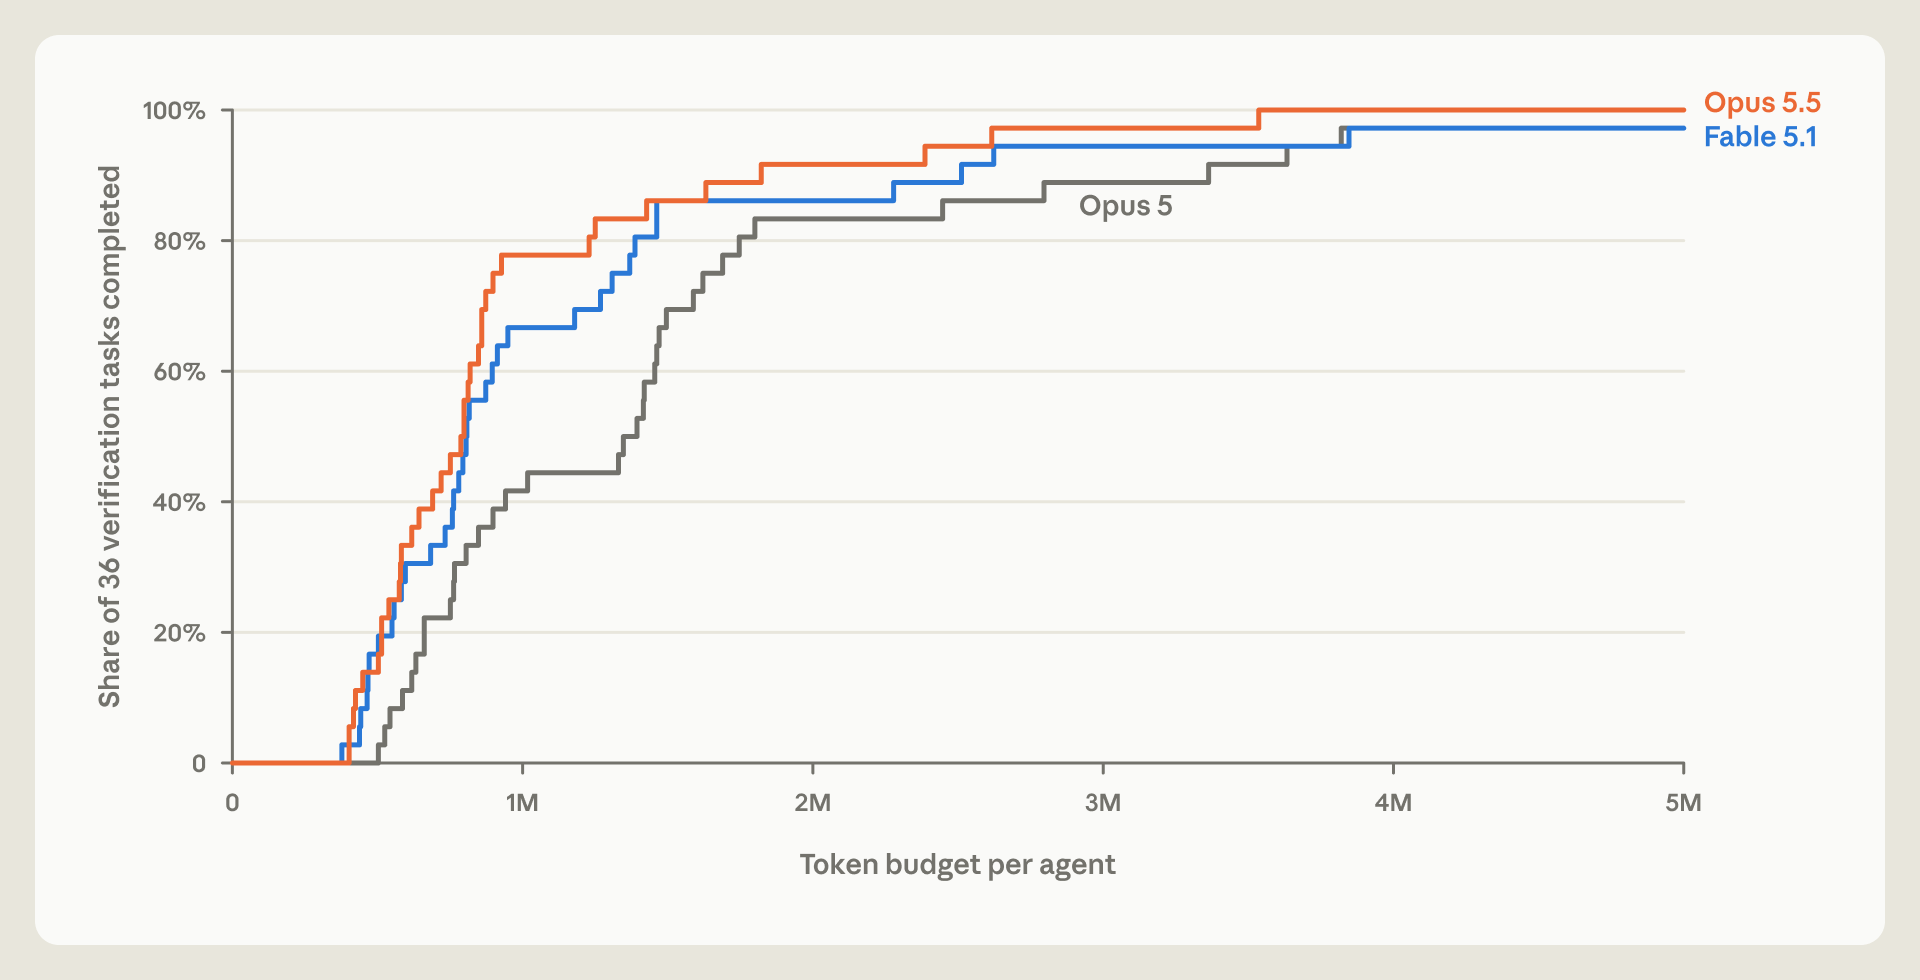
图 3:模型能力与证明构造的 token 消耗。横轴为每个智能体的 token 预算,纵轴为已完成任务的比例。每项任务安排三次独立尝试,以最先成功的一次计入结果,每次尝试的预算上限为 500 万 token。图片来源:Anthropic 原博文。
证明复用实验允许智能体访问共享工作区,复制其他智能体的证明并加以修改。与独立工作相比,token 消耗减少了 17%,部分原先失败的任务也得以完成。
Anthropic 还让 Claude 用 Rust 编写了一个支持部分 Python 功能的解释器,并使用 Rust 验证工具 Verus 检查其正确性。实验依据一篇论文中的语义定义了 Python 子集的形式语义,并证明:只要解释器返回结果,该结果就符合这套形式语义。为了检验这套规则与实际使用的 CPython 是否一致,实验还运行了超过 170 万个以随机生成为主的 Python 程序,其中 99.95% 的测试结果一致,其余差异被归于已知的边界情况。
二、具体技术路线
这些验证项目以 OSS-Fuzz 原有模糊测试中要检查的条件作为形式化验证的目标。验证时,测试代码及其依赖的库函数代码一起被编译为 RISC-V 机器码,再在定理证明器 Rocq 中证明这些机器码满足前面提到的安全性与功能正确性条件。图 4 展示了这一流程。

图 4:验证流程总览。源码与证明代码经过节选和简化处理。点击图片可查看大图。
1. 模糊测试代码如何表达验证要求
这里的模糊测试代码是一个接收输入、调用目标库并检查执行结果的小程序。它规定输入如何被解析或转换、调用哪些函数,以及怎样判断结果是否符合要求。模糊测试工具负责生成输入,反复执行这个程序;测试代码本身则写下了调用方式和检查要求。
以 bzip2 为例,测试代码把输入交给压缩函数,再解压缩所得数据;两步都成功后,通过 assert 检查还原长度和内容。这里的断言表达了往返还原(roundtrip)性质:压缩、解压成功时,应当还原原始输入。对于一般的编解码过程,这一性质可以写成 decode(encode(x)) = x。长度或内容不一致,就会触发断言失败,使测试中止。
普通模糊测试通过随机生成或变异输入,反复运行测试来寻找错误。即使运行了大量测试用例,也不能据此保证所有可能情况都已覆盖,尤其是需要特殊输入组合才能触发的边缘情况(corner cases)。测试始终没有报错,也可能只是尚未生成能够触发错误的输入。
Anthropic 与 Theorem 团队的方法则是用形式化验证证明:在规定的输入范围和运行条件下,无论给这段测试代码什么输入,执行都不会出错。这一结论覆盖范围内的所有输入,包括随机测试没有生成过的边缘输入。断言失败会触发 abort,也属于要排除的错误,因此每次执行到断言时,比较都必须成立。图 5 展示了如何由此得到 bzip2 的往返还原保证。

图 5:bzip2 的测试断言如何成为证明结论。64 MiB 限制针对包含驱动头部的输入文件。点击图片可查看大图。
这里的 64 MiB 是本次测试驱动设置的输入上限,并非这条验证路线的固有限制。按照公开的输入处理规则,文件达到或超过这一大小时,驱动会直接退出,不再调用被测库。因此,现有证明对更大输入保证的是这条退出路径,而不是库函数对它们的处理;若要扩大验证范围,需要修改驱动并重新证明。
bzip2 的测试在压缩或解压失败时直接返回,两步都成功后才检查还原结果。因此,这里的功能保证是:只要压缩和解压成功,还原数据的长度与内容就必须和输入一致。
理解这类验证结果,关键在于看测试检查了什么。如果测试只是调用编码器,却不检查输出,那么证明测试不会出错,并不能保证编码结果正确。证明过程中还可能建立更强的函数性质,第三节将结合公开代码进一步说明。
2. 验证对象:编译后的 RISC-V 机器码
每个模糊测试入口对应一个独立的验证任务。测试入口、被调用的库代码和所需的运行库代码会一起编译、链接为一个可执行文件。Anthropic 与 Theorem 选择在程序验证中,以这个文件为验证对象,分析其中机器指令的行为,进而证明其安全性与功能正确性。
图 6 左侧是前述 bzip2 测试入口,右侧展示调用和检查在可执行文件中对应的机器指令。malloc、free、memcmp 等运行库函数也包含在同一文件中。

图 6:bzip2 从 C 测试代码到 RISC-V 可执行文件。汇编取自公开版本的普通版 ELF。点击图片可查看大图。
具体编译时,Clang 将测试入口、目标库和负责读取输入的驱动程序编译为 64 位 RISC-V 程序,并静态链接 musl 等运行库。公开版本的编译配置采用 -march=rv64g,默认优化选项为 -Os,部分库还会追加 -O3。因此,证明面对的是编译器优化后的机器码,包括函数内联、寄存器分配和控制流变换的结果。每份证明对应的二进制文件、库版本和编译参数,都记录在仓库中。
除了普通版,测试代码和目标库还会被编译为加入运行时检查的版本。这些检查由编译器插入代码中,也称为插桩。这里使用两种工具:
- ASan(AddressSanitizer):检测越界访问、释放后使用等内存错误。
- UBSan(UndefinedBehaviorSanitizer):检测有符号整数溢出、整数除零等未定义行为,具体覆盖范围取决于启用的检查选项。
公开版本中,每个测试入口最多有普通版、ASan 版、UBSan 版和同时启用两者的版本,共四种构建。某些源码层面的错误在机器码中并不会直接导致执行失败;加入检查后,这些错误会触发程序中止或执行故障。因此,对加入检查的版本证明“执行不出错”,就能排除相应检查能够检测的错误。同时,验证时还需要额外要求插桩后的版本与原版的可观察行为一致,确保插桩没有改变程序的对外行为。
3. 从模糊测试二进制到 Rocq 命题
Rocq(原名 Coq)是一款交互式定理证明器,它的逻辑内核检查证明步骤是否成立。要在 Rocq 中证明机器码的性质,需要先对程序的执行行为进行形式化建模。
Theorem 提供的 LPS(Linux Process Semantics)模型在 Rocq 中对运行静态 64 位 RISC-V 程序的单线程 Linux 进程进行了建模,描述寄存器和内存状态、指令执行以及系统调用的行为。例如,一条加载指令如何读取内存,read 可能读到多少字节,mmap 可能返回哪些地址,都在模型中描述。证明需要覆盖模型允许的各种执行情况。
在这一模型的基础上,将具体可执行文件中的指令和数据编码为 Rocq 定义,就可以陈述该程序需要满足的正确性条件。图 7 用 bzip2 的普通版和 ASan 版展示从二进制文件到待证明命题的过程。

图 7:bzip2 从可执行文件到 Rocq 命题。Rocq 代码经过节选,右侧将 agrees_in 展开为便于阅读的记法。点击图片可查看大图。
图 7 展示了 Rocq 如何引用待验证的两个程序。左侧文件保存普通版和 ASan 版可执行文件的各个加载段;Plain.v、Asan.v 和 Images.v 读取这些文件并组织成 Rocq 中的两份程序镜像。右侧的 asan_agrees 引用这两份镜像,写出需要证明的性质。
asan_agrees 有两个最终结论。其一,两版执行均无错误。由于测试断言已编译进两版程序,因此这一要求也包含第 1 小节所述的往返还原保证:压缩和解压缩成功时,还原数据与输入等长且内容完全相同。“无错误”还排除内存访问故障、ASan 检查失败导致的中止,以及执行模型未定义的行为。
其二,在相同输入下,两版可能产生的可观察行为集合相同。这里的“可观察行为”包括标准流和网络连接上读写的字节、退出状态和文件最终内容,不包括内部执行过程,例如走过的指令、寄存器中的值和内存地址。从逻辑上讲,只需要检查带 ASan 版的程序的正确性即可,但是为了证明“加入内存安全检查”本身没有触发不同的编译优化、意外引入错误的程序行为,又验证了普通版和 ASan 版的正确性和二者的等价性。
4. Claude 构造证明,Rocq 检查结果
在 Rocq 中形式化地写出正确性命题之后,接下来的任务是给出证明,把两份程序的指令行为连接到“运行无错误”和“行为一致”这两个结论。Claude 为此编写中间引理和证明步骤,也编写工具生成重复性内容。Rocq 负责检查 Claude 提交的证明;检查失败时,错误信息用于修改并再次提交。整个命题通过检查,才算完成了这一步。
为防止 AI 在面对复杂的证明时走捷径、擅自篡改输入程序的定义或引入非法的底层公理,整个流程还配备了额外的安全审计机制。仓库的 oft check 工具专门用于核对二进制文件,根据其中的真实代码与数据重构待证命题,并检查提交的证明是否确切对应于该命题。同时,它还会严格筛查证明所依赖的公理(Axioms),确保其处于预先允许的安全集合内。最终检查由此将目标二进制、正确性命题和通过 Rocq 核验的证明对应起来。
5. 证明构造:从局部条件到整个程序
前面介绍的最终验证目标针对整个测试程序:在约定条件下,执行不会出错,编译后的测试断言都能通过检查,插桩版与普通版的可观察行为一致。为了证明这些结论,Claude 在证明过程中构造了大量霍尔逻辑形式的函数级中间结论。这种形式在程序验证中被广泛使用:如果函数入口处的寄存器和内存满足某个前提(前置条件),执行后就能保证某个结论(后置条件)。调用方的证明再利用这些中间结论,逐步建立整个测试程序的性质。
下面三个例子的区别在于建模时如何描述程序行为:直接描述机器状态,用纯函数描述计算结果,或用 Monad 程序描述操作顺序和状态变化。这些描述随后被用于函数的前置条件、后置条件或实现规格,将局部证明与最终验证目标联系起来。
直接机器状态推理:逐字节比较两段内存
这种方法在建模时,直接用寄存器和内存描述函数执行前后的状态。以 coturn 中静态链接的 musl memcmp 为例,前置条件规定两个输入区间可读、地址不回绕;比较结果则写成对返回寄存器的要求:遇到首个不同字节时保存两者之差,全部相同时保存零。证明随后跟踪指针、长度、字节读取和分支跳转,并对循环剩余长度归纳。ref_memcmp 最终证明机器执行满足这些条件,同时保证内存不变、只有指定寄存器可以改变。
展开 memcmp 的 C 源码、机器指令与证明条件
C 与机器码。 以下为 musl 的完整函数。循环体为空,指针移动和长度递减都在 for 的更新部分完成。

对应的 RISC-V 函数共 12 条指令,从 0x23610 开始,没有调用其他函数。函数开始执行时,a0、a1 保存两个指针,a2 保存长度;循环把读到的字节放入 a3、a4。

建模:直接约束机器状态。 RefMemcmp.v 要求两段长度为 n 的内存可读,长度可表示为 64 位值,且区间末端不发生地址回绕;参数寄存器与返回地址也需满足函数的调用约定。后置条件 mc_post 直接约束返回时的寄存器:位置 i 之前的字节都相等;若 i = n,返回寄存器为零,否则保存第 i 对不同字节的差。这里把比较规则写成了状态应当满足的命题。
Definition mc_post (regs' : bvmap 5 word) (i : nat) : Prop :=
    (i <= n)%nat /\ (forall j, (j < i)%nat -> LA j = LB j)
    /\ ((i = n /\ getr regs' 10 = Z_to_bv 64 0)
        \/ ((i < n)%nat /\ LA i <> LB i /\ getr regs' 10 = v_sub (LBv (LA i)) (LBv (LB i)))).
其中 LA i、LB i 是两个输入字节列表的第 i 项,getr regs' 10 是返回寄存器 a0,LBv 将无符号字节扩展为机器字。
证明:从函数调用前的状态推导返回状态。 ref_memcmp 说明,从满足前置条件的状态出发,机器执行能够到达满足 mc_post 的返回状态。完整陈述如下,其中内存条件定义在该定理所在的 Section 中:
Theorem ref_memcmp : forall regs (ret : word),
    ret_ok ret -> getr regs 1 = ret ->
    getr regs 10 = l -> getr regs 11 = r -> getr regs 12 = Z_to_bv 64 (Z.of_nat n) ->
    exists regs' (i : nat),
      msteps SEGS (mkst regs (0x23610 : word) mem rom) (mkst regs' ret mem rom)
      /\ regs_agree (fun x => In x memcmp_clob) regs regs' /\ mc_post regs' i.
msteps 表示从函数开始执行到返回的一段机器执行。两端使用同一个 mem,说明内存不变;regs_agree 允许 a0 至 a4 改变,其余寄存器保持原值。证明按指令逐步展开,分别处理零长度、当前字节不同,以及字节相同后继续循环三种情况。字节读取通过 step_lbu 核验,循环则对剩余长度归纳,最终得到返回寄存器满足 mc_post 的结论。
调用方使用的 cmp_spec 只保留返回值在 [-255, 255] 内等执行约束。MEMCMP_src0 从上述更强的函数定理推出这个契约,再将它用于 coturn 的证书检查证明。
使用 Rocq 函数辅助推理:判断大整数的奇偶性
这种方法在建模时,用纯函数描述输入与计算结果的关系,不涉及具体的寄存器和栈。例如,OpenSSL 的 BN_is_odd 判断大整数是否为奇数,对应的 Rocq 纯函数根据有效数字位数和最低数字位算出一个布尔值。证明随后把内存中的大整数对应到模型输入,再证明返回寄存器中的 0 或 1 正好表示模型算出的真假,即机器码的返回值与纯函数的结果一致。
展开 BN_is_odd 的源码、纯函数模型与实现证明
C 与机器码。 OpenSSL 的完整函数先检查有效数字位数 top,再读取数字数组 d 的第一个元素,通过最低二进制位判断奇偶性。零没有有效数字位,直接返回 0。

对应的 RISC-V 函数从 0xf6f28 开始,共 15 条指令,没有调用其他函数。lw 读取 top,blez 在其不大于零时跳到返回 0 的分支;另一条路径读取数字数组指针,再通过 lwu 和 andi 提取最低二进制位。这里每个数字位占 64 位,但判断奇偶只需最低一位,所以机器码只加载其中的低 32 位。

建模:用纯函数定义计算结果。 BgLib.v 将大整数表示为抽象记录,用下面的纯函数计算它是否为奇数:
Definition is_odd_pure {ptr} (a : bignum ptr) : bool :=
  (0 <? bn_top a)%nat &&
  Z.odd (nth 0 (bn_buf a) 0).
bn_top 是有效数字位数,bn_buf 是数字列表;nth 0 (bn_buf a) 0 取首项,列表为空时取 0。Z.odd 判断该项是否为奇数,对应 C 中的按位与 1。更高数字位的权重都是偶数,因此只需检查最低数字位。这个定义只根据抽象输入计算布尔结果,不包含读取哪个地址、使用哪个寄存器等机器操作。
证明:机器返回值等于纯函数结果。 BN_is_odd_spec 要求内存中的大整数对象和数字数组符合模型,数字位与容量满足范围条件,并有不与对象及数组重叠的 16 字节栈空间。它的后置条件包含以下返回值等式:
a0' = Z_to_bv 64 (Z.b2z (is_odd_pure b))
这个等式就是纯函数与机器实现的对应关系:a0' 是返回寄存器,Z.b2z 将布尔结果转为整数 0 或 1,Z_to_bv 64 再将其转为机器字。证明分别执行零和非零两条路径,用 Z.land_ones、Zodd_mod 证明按位与 1 得到的值等于模型中的奇偶判断,并检查栈帧和寄存器是否按约定恢复。
使用 Monad 程序辅助推理:保留源码的操作顺序与状态变化
这种方法在建模时,编写结构接近源程序的 Monad 程序,描述程序的操作顺序和状态变化。以 BN_new 为例,C 源码依次分配空间、初始化对象并返回指针;对应的 Monad 程序也按这个顺序写出分配、状态更新和返回操作,省去具体地址和内存布局等细节。与上例用纯函数直接描述计算结果相比,这里保留了操作顺序和状态变化。随后再证明机器码的执行与这段 Monad 程序对应。下面的程序覆盖成功分配路径,分配失败被标记为不可达。
展开 BN_new 的源码、Monad 程序与机器实现的对应关系
C 与机器码。 OpenSSL 的完整函数先申请清零的空间,成功后设置 BN_FLG_MALLOCED 标记。

在对应机器码中,0x18 是对象大小,即 24 字节;jal 0xe1e00 调用 CRYPTO_zalloc,sw a1, 0x14(a0) 将标记写入对象。函数还保存并恢复返回地址和 s0 寄存器。

建模:写出与源码结构接近的 Monad 程序。 BgLib.v 中的定义为:
Definition BN_new (r : bnref) : BM ptr :=
  p <- bmalloc ops BN_STRUCT_BYTES ;;
  bset r (bn_nil BN_FLG_MALLOCED) ;;;
  bret p.
这三行保留了源码的主要步骤:bmalloc 申请空间并把指针记为 p;bset 将引用 r 对应的抽象对象设为带分配标记的零值,概括源码中的清零和标记设置;bret p 返回指针。程序中不需要写出对象字段的内存偏移,也不需要指定寄存器。
<- ... ;; 和 ;;; 由绑定操作 bbind 实现,负责按顺序执行,并把结果和状态传给后一步。类型 BM A := ST -> M (A * ST) 表示接收抽象状态 ST,执行计算,得到结果和新状态;底层 M 承载分配等操作。Monad 程序仍由函数定义实现,只是把状态传递封装起来,使这段描述能够保留源码中“先分配、再初始化、最后返回”的结构。
证明:机器执行实现这段 Monad 程序。 BN_new_walk 用 implM 表达两者的对应关系。在堆、栈、对象布局及分配器规格等前提下,证明将抽象对象引用 r 对应到实际地址,确认对象占据 24 字节,并说明机器中的分配调用、字段写入和返回实现了上述三个步骤。这里既要核对返回指针,也要核对初始化后的对象状态。
这段 Monad 程序中的 bmalloc 将分配失败的 None 映射为 unreachable,因此不能据此声称它完整描述了 C 函数返回 NULL 的所有情形。这里的分配也是库级操作,不是一次直接的 Linux 系统调用。
有了这些函数级证明,分析调用方时就可以先检查调用前是否满足相应的前置条件,再利用后置条件继续分析后续代码。整个测试入口的证明由此逐步覆盖库函数调用、结果检查和最终返回。
三、证明的结论与范围
原始 OSS-Fuzz 测试包含许多压缩还原、编码解码后结果是否一致等功能检查,而此次公开发布的证明目前只覆盖了其中一小部分。许多检查尚未完成验证,还有一些测试目标尚未纳入本次发布。以下分析以此次公开材料为依据。
展开尚未纳入发布的测试及参考材料
以下四个项目中有 18 个包含往返结果比较的测试目标,未纳入此次发布的对应声明和证明。表中链接分别给出发布记录与一处上游检查示例。
| 项目与测试范围 | 此次发布记录 | 上游检查示例 |
|---|---|---|
| Glaze:JSON、CBOR、MessagePack 的整数、浮点数和字符串往返,共 9 个目标 | 已构建,尚未纳入发布 | JSON 整数序列化后重新解析,检查数值相等 |
| Rawspeed:位流写入与读取往返,1 个目标 | 已构建,尚未纳入发布 | 逐项读回写入的位字段,检查数值相等 |
| Zstd:普通、流式、字典等压缩往返,共 6 个目标 | 尚未构建 | 压缩后解压,检查还原长度与字节内容 |
| SerenityOS:Base64 和 Gzip 往返,2 个目标 | 尚未构建 | Base64 编码后解码,检查恢复结果等于输入 |
这些测试已经写出了往返还原的检查要求,但此次公开材料没有提供对应的证明。
下表选取六个检查已进入二进制的测试入口:两个已有公开证明,四个仍标记为 open(尚未被证明或反驳)。
| 测试入口 | 测试代码检查的性质 | 公开证明 |
|---|---|---|
bzip2 bzip2_compress_target |
压缩后解压,还原长度和全部字节 | 已证明 |
zstd fse_read_ncount |
FSE 频数表写入再读回,表项和参数一致 | 已证明 |
LZ4 round_trip_fuzzer |
压缩后解压还原输入;部分解压还原相应前缀 | open |
zstd huf_round_trip |
Huffman 压缩成功时,解压还原输入 | open |
nanopb fuzztest_io_errors |
解码、编码后再次往返,输出长度与校验值保持一致 | open |
zlib checksum_fuzzer |
分段计算与一次计算的 CRC-32、Adler-32 校验值一致 | open |
对于前面介绍的往返还原性质,bzip2 的测试代码在压缩、解压成功后比较长度与全部字节,因此对应的是完整输入字节串的还原;zstd 的 fse_read_ncount 则检查 FSE 频数表及其参数写入后能否读回,保证的是这部分数据的还原。对于表中的 LZ4 压缩、zstd Huffman 压缩和 nanopb 编解码测试,此次公开材料尚未给出相应的往返还原证明。
zlib 的 checksum_fuzzer 检查的是校验值的一致性:同一份数据分段计算与一次性计算,应得到相同的 CRC-32 和 Adler-32 校验值。这些检查已保留在编译后的程序中,但对应的验证命题仍未被证明或反驳。
jsoncons 的 fuzz_json_encoder 虽然已有公开证明,但并未证明 JSON 编解码的往返还原性质。
展开 jsoncons 的测试内容与已证明结论
jsoncons 的 fuzz_json_encoder 将 JSON 读取器与字符串编码器连接起来,结果写入 s2 后,测试入口便返回,没有再次解析输出并比较转换前后的数据含义。
这个测试入口公开的证明记录包括 asan_agrees 和 asan_ubsan_agrees:在约定的输入、内存与运行条件下,普通版和相应插桩版均不发生执行错误,且可观察行为一致。这排除了这些检查能够检测的错误,但没有证明输出仍表示原来的 JSON 数据。若要用测试表达后者,需要增加解析输出、比较数据含义的检查;字段顺序或空白可以不同,字段值则应当保持一致。
内部定理也可能建立测试断言之外的功能性质。 OpenSSL 的模幂和除法测试在结果比较失败时并没有触发错误,因此“没有错误”的证明结论无法推出比较一定成功。但是它们的内部证明进一步建立了算术关系,并据此排除了比较失败的分支。
具体而言,模幂证明建立了优化实现和参考实现都计算 ,其中指数非负、模数非零,并满足相应的对象和内存条件;除法证明建立了商余数关系 ,以及相应的符号规则。这些数学结论通过函数规格和实现证明连接到编译后的代码。
四、优势与局限
路线优势
不同源语言可以共用验证工具。 因为 Anthropic 与 Theorem 采取的技术路线是验证编译后的 RISC-V 机器码,所以只要程序能够编译、链接为执行模型支持的二进制,就可以使用同一套指令和进程语义开展证明。C、C++ 等语言的差异,以及它们依赖的运行库,最终都表现为可执行文件中的指令和数据。QCP、Dafny、Frama-C/WP、VST 等工具直接验证程序源码,因此需要对每种支持的程序语言各自定义其形式化语义,验证工具需要随源语言重新设计。
证明直接针对编译结果,也减少了对编译正确性的依赖。源码级证明要用于实际运行的程序,需要信任编译工具链,或借助 CompCert 这类经过验证的编译器,建立源码与生成汇编之间的语义联系。这里则直接检查特定二进制是否满足要求,编译优化产生的代码也一并进入证明范围。
验证要求直接体现在测试代码中。 开发者可以从测试代码中看出程序如何调用库函数,以及怎样检查计算结果。例如,bzip2 在压缩、解压成功后,用两条比较语句检查结果的长度和内容是否与输入一致。开发者读懂这段测试,就能理解相应的功能保证,不需要为此额外掌握形式化验证的专业理论知识。利用已有测试,也省去了为这些检查另写一套逻辑规约的工作,降低了形式化验证的使用门槛。
路线局限
覆盖所有输入,不等于覆盖所有验证要求。 形式化证明可以覆盖随机测试未命中的边缘输入,但不会自动补上测试中缺少的检查。要通过这条路线全面保证程序的安全性和功能正确性,一个必要条件是:所有需要验证的安全性和功能要求,都能完整、准确地写成测试代码中的检查,或由配套的运行时检查体现。 如果某项要求没有被表达出来,仅凭测试入口的无错误结论,就不能断言程序满足它。
复杂的规格难以用测试表述。 有些性质用数学语言容易表达,写成测试程序却很麻烦。以最短路为例,设有向图 : 是顶点集合, 是边集合, 为每条边给出非负权重。设 是从起点 到终点 所有路径的集合, 是路径 上各条边的权重之和。若程序返回路径 ,正确性规格可以写成:
这要求返回一条合法路径,且其长度不超过任何其他路径。igraph 的 OSS-Fuzz 测试入口会根据输入字节生成图,再调用距离计算和最短路函数,但没有检查返回路径的长度或最优性。若要用测试代码表达上述规格,就得增加可执行的检查,例如另写一个参考算法并比较结果。但是这样一来,参考算法自身的正确性又成为问题。
同一函数在不同测试入口被反复验证。 每个测试入口都单独编译为包含依赖库函数的可执行文件,证明也要覆盖这些函数。同一份源码出现在不同可执行文件中时,生成的指令、寄存器分配和地址可能不同,已有证明需要据此调整。研究报告展示的跨程序复用,就是复制已有证明,再针对新程序修改。公开仓库中也存在重复的证明文本:我们统计了 simdjson 的 10 个测试入口,统一各测试入口对应的命名空间前缀后,对不同测试入口中相同的文件仅保留一份,证明文本的总字节数可减少约 15.26%。
本文作者使用的 QCP 等源码级工具通过函数规约组织模块化验证:先证明函数实现满足规约,之后验证不同调用者时,只需检查调用条件并使用规约给出的结论,无须反复展开被调用函数的实现。
编译优化后的机器码增加了推理难度。 公开版本中的程序在编译时已经启用了优化:默认使用以减小代码体积为目标的 -Os,部分库还使用了更激进的 -O3。经过优化后,函数调用可能被替换为直接展开的函数体,同一个寄存器可能在不同阶段保存不同变量,原有的分支和循环结构也可能发生变化。证明需要说明这些变化如何保留原有算法的行为;技术附录中的专家分析也指出,大量证明篇幅用于处理寄存器、栈地址、类型转换和分支等底层细节。而源码级证明可以围绕原有的语句、变量和循环展开,减少处理这些编译细节的工作。
从此次公开材料看,较突出的功能正确性成果包括编解码的往返还原、长度与结构约束,以及大整数的算术关系,功能性质的覆盖范围仍然有限。例如,第三节列出的 LZ4 压缩和 zstd Huffman 压缩测试入口,其往返还原要求已写入测试,但对应的验证命题仍未被证明或反驳。
在源码级验证方面,本文作者使用的 QCP 已完成并公开了 C 语言 CDCL SAT 求解器的功能正确性验证:在满足前置条件时,求解器若返回 SAT,给出的赋值就满足原始公式;若返回 UNSAT,原始公式就不存在满足赋值。QCP 团队发布的 PV-BENCH 还收录了 233 个带有规约和证明的 C 程序实例,涵盖排序、最小生成树、图遍历等算法。我们期待 Anthropic 与 Theorem 后续也能基于机器码验证路线,公开更多复杂程序及其复杂功能性质的验证结果。
证明结论绑定特定编译结果。 源码修改、编译器更新,甚至优化或链接选项的调整,都可能改变二进制文件。要继续使用旧证明,需要检查新二进制中的指令、地址和调用关系是否发生变化,再修改受影响的证明。因此,证明也需要随软件版本持续维护。
源码级证明的维护主要围绕源码和规约展开。在语言语义不变的前提下,仅调整编译选项通常不会改变源码层面的证明义务;源码修改后,函数规约也有助于确定哪些调用方证明需要调整。机器码路线还要应对编译结果本身的变化。现有实验展示了批量完成证明的能力,但软件频繁更新时需要投入多少维护工作,还需要在后续实践中评估。
五、总结
这项工作有力地展示了 AI 辅助定理证明的巨大潜力。该方案直接面向编译后的机器码,在多个真实开源项目上实现了大规模验证,并通过 Rocq 保证了证明结果的严格性,为定理证明通往大规模软件工程落地提供了切实的实践范例。
然而,这一技术路线也伴随着清晰的权衡:
- 抽象层级与复杂度的平衡:机器码层面的验证打破了源码语言的壁垒,实现了通用性,但也引入了编译优化与底层执行细节,增加了形式化验证的负担,也可能推高 LLM 构造证明时的 token 消耗;
- 规格构建与验证深度的取舍:以现有测试套件作为验证规格降低了形式化验证的使用门槛,但难以表达复杂程序的复杂功能正确性条件;
- 工程可扩展性与维护成本的挑战:各测试入口独立验证,且证明与特定二进制绑定,使得证明难以模块化组织和复用,在软件迭代时可能产生高昂的迁移与维护开销。
我们将持续关注 Anthropic、Theorem 和世界范围内其他形式化验证团队的最新成果。